OpenAI colocó su nueva marca de agua de texto justo donde termina la ley, y el mapa que eligió dice más sobre el negocio que sobre la tecnología.
OpenAI añadirá una marca de agua estadística invisible, llamada textGrain, a los textos de ChatGPT y Codex en la Unión Europea durante las próximas semanas para cumplir con la Ley de IA de la UE. En el resto del mundo, los textos de ChatGPT para usuarios particulares no llevan ninguna marca. Los clientes de la API pueden activar la marca de agua para determinados modelos, pero viene activada por defecto, y el detector que la lee solo está disponible, por ahora, para investigadores autorizados.
En abril de 2023, OpenAI hizo una pregunta directa a los usuarios de ChatGPT. Casi el 30 % afirmó que usaría menos el producto si este añadía una marca de agua a su texto, mientras que un competidor no lo hacía. Esta encuesta, publicada por The Wall Street Journal en 2024, es una de las principales razones por las que una función de marca de agua que OpenAI ya tenía en funcionamiento permaneció archivada durante años.
Tres años después, la situación ha cambiado. Google lleva marca de agua en el texto de Gemini desde 2024. Anthropic empezó a marcar el trabajo de Claude en todo el mundo en agosto. Y el lunes, OpenAI activó su propia marca en una sola región.
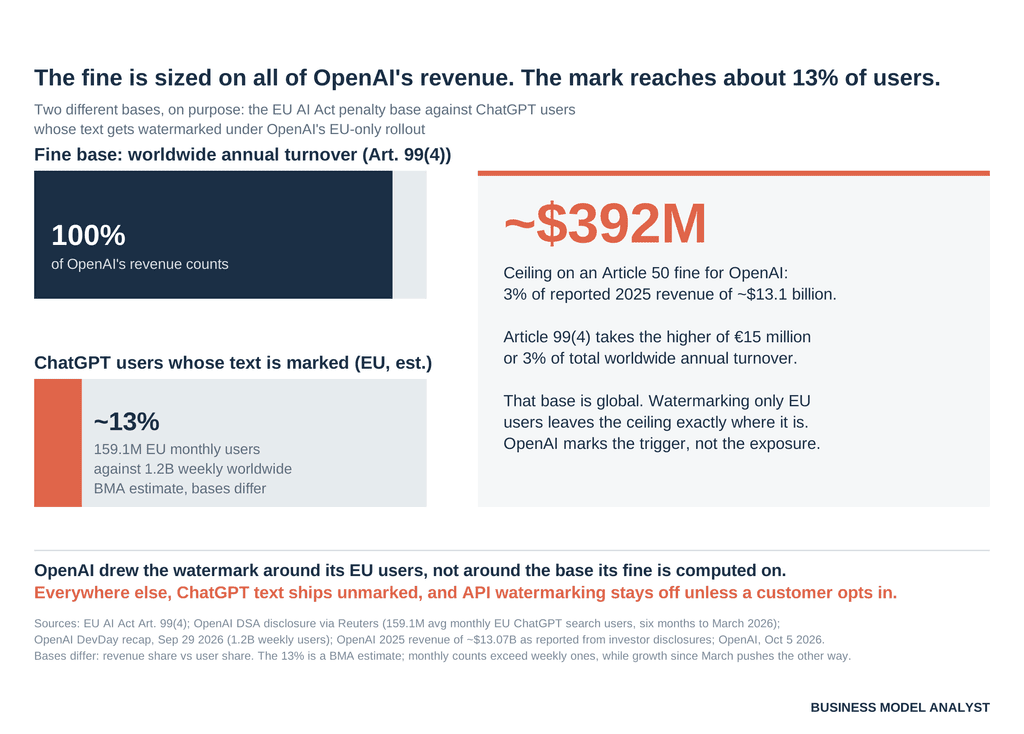
Si se realiza el cálculo en esa región, aparece una forma extraña. El margen de error que OpenAI evita se basa en el 100% de sus ingresos mundiales. La marca de agua que creó para ello alcanza aproximadamente el 13% de los usuarios semanales de ChatGPT. Fuera de Europa, OpenAI se ha convertido en el rival según su propia encuesta.
Qué pasó
OpenAI presentó el plan el 5 de octubre en una publicación titulada Nuestro enfoque para las reglas de procedencia de textos de la UE, y TechCrunch lo reportó el mismo día. El lanzamiento consta de tres partes, y cada una viene con una configuración predeterminada diferente:
- ChatGPT y Codex: con marca de agua para usuarios elegibles en todos los planes, solo en la UE, con implementación gradual en las próximas semanas. OpenAI declara explícitamente que no convertirá la marca de agua de texto en una opción predeterminada global en el lanzamiento.
- La API estará disponible en todo el mundo a partir del lunes como opción para modelos seleccionados; estará desactivada por defecto. OpenAI afirma que está colaborando con sus socios en la nube para ofrecer la misma opción en sus plataformas.
- El detector: las solicitudes están abiertas, y el acceso se concede caso por caso a investigadores y organizaciones expertas aprobadas. No habrá una herramienta pública en su lanzamiento.
El método, llamado textGrain, influye en la selección de palabras del modelo mediante una clave secreta. El resultado es un patrón estadístico que un lector no puede ver, pero que un detector que posea la clave sí. Dado que la señal reside en las propias palabras, se conserva incluso después de copiar y pegar. OpenAI publicó un informe técnico, escrito en colaboración con investigadores de la Universidad de Pensilvania y Yale, donde anuncia su intención de liberar el código fuente de la tecnología y afirma que textGrain igualó o superó a todas las alternativas probadas, incluyendo SynthID de Google.
La empresa fue inusualmente franca respecto a las limitaciones. Con un objetivo de falsos positivos del 1%, su detector acertó aproximadamente el 80% de los pasajes de 200 palabras y el 95% de los de 400 palabras en preguntas de psicología, mientras que las respuestas de matemáticas obtuvieron puntuaciones mucho más bajas. Si se sustituye el 10% de las palabras de un pasaje de 400 palabras por sinónimos, la detección cae de aproximadamente el 92% al 66%. Si se sustituye el 25%, la precisión se reduce al 17%.
La calidad se mantuvo. En la tabla comparativa de OpenAI para Astra, su modelo de vanguardia más reciente, las puntuaciones de las versiones con y sin marca de agua se sitúan a tan solo un punto de diferencia en la mayoría de las pruebas: 94,44 % frente a 93,94 % en GPQA Diamond, 87,92 % frente a 87,35 % en BrowseComp. En un par de pruebas, la versión con marca de agua obtuvo incluso una puntuación superior.
Dos líneas más de la publicación son importantes. La marca no identifica al usuario, y la ausencia de una marca no prueba que un humano haya escrito el texto.
La historia de fondo
El artículo 50 de la Ley de IA de la UE entró en vigor el 2 de agosto de 2026. Este artículo exige a los proveedores de sistemas de IA generativa que marquen los resultados sintéticos de forma legible y detectable por máquina. Los sistemas que ya estaban en el mercado antes de esa fecha tienen hasta el 2 de diciembre para cumplir con la normativa, y los proveedores necesitan una solución de interoperabilidad para la detección antes del 2 de febrero de 2027. Según el artículo 99(4), el incumplimiento del artículo 50 puede acarrear multas de hasta 15 millones de euros o el 3 % de la facturación anual mundial total, lo que sea mayor.
OpenAI firmó el Código de Buenas Prácticas de la UE sobre contenido generado por IA junto con Anthropic, Google, Meta y Microsoft. Sin embargo, su marca de agua de texto es anterior a la normativa. Según un informe del Journal de 2024, el sistema se había debatido internamente durante unos dos años y tenía una efectividad del 99,9 % cuando se generaba suficiente texto nuevo. Dos encuestas de abril de 2023 arrojaron resultados opuestos. En todo el mundo, la gente apoyaba una herramienta de detección de IA en una proporción de cuatro a uno. Entre los usuarios de ChatGPT, el 69 % creía que la detección de trampas produciría acusaciones falsas, y casi el 30 % dijo que usaría menos ChatGPT si este incluyera una marca de agua y un competidor no.
Entonces los rivales se movieron. Google DeepMind publicó SynthID-Text en Nature en octubre de 2024 e informó que ya estaba disponible en Gemini, después de que una prueba con casi 20 millones de respuestas no encontrara diferencias significativas en las calificaciones de los usuarios. Anthropic anunció el 11 de agosto que Claude marcaría texto en todo el mundo, a través de su API, sus aplicaciones y los principales mercados en la nube, noticia que cubrimos cuando se lanzó. Esa decisión tuvo un precio. En menos de un día, TechCrunch informaba sobre usuarios de Claude molestos porque el trabajo que habían dirigido llevaría la firma de una máquina.
Una corrección a nuestra interpretación. En agosto argumentamos que Anthropic se globalizó porque una ruta de inferencia cuesta menos que dos. Posteriormente, Anthropic afirmó que el despliegue mundial reflejaba la falta de un método duradero para delimitar el alcance del marcado por región. OpenAI ha realizado ahora el otro experimento y ha concluido que vale la pena pagar por dos rutas.
El plan
Si se colocan los tres interruptores uno encima del otro, el principio de diseño queda claro. OpenAI indica qué productos distribuye OpenAI en la jurisdicción que lo requiere, y ofrece un interruptor para todo lo demás.
Esto se ajusta a la ley. El artículo 50(2) impone la obligación de marcar la marca al proveedor del sistema de IA. ChatGPT es el sistema de OpenAI, por lo que ChatGPT es quien debe marcar la marca en la UE. Una empresa que desarrolla su propia aplicación sobre la API es, en principio, el proveedor de dicha aplicación. La publicación de OpenAI indica que la opción de aceptación permite a los clientes decidir cómo se ajusta la marca de agua a sus obligaciones de transparencia. En resumen: la decisión y la obligación se trasladan conjuntamente.
La puerta del detector completa el diseño. OpenAI cita el Código de Buenas Prácticas para justificar el acceso caso por caso y el riesgo de errores y falsos positivos para mantener la herramienta cerrada. Ambas razones son válidas. El efecto secundario comercial también es real. Una marca de agua solo cambia el comportamiento cuando alguien distinto del emisor puede leerla, que es precisamente la razón por la que la detección por IA se convirtió en un negocio . En el caso del texto, los únicos lectores por ahora son OpenAI y los investigadores que aprueba.
Compárese esto con las imágenes y el audio. OpenAI ya cuenta con una herramienta de verificación pública en openai.com/verify para ambos. Cuando la señal es robusta, la empresa permite que cualquiera la compruebe. Cuando es frágil, guarda la clave.
El ángulo del modelo de negocio
Comencemos con la cobertura. En su informe conforme a la Ley de Servicios Digitales, OpenAI reportó un promedio de 159,1 millones de usuarios activos mensuales de ChatGPT en la UE durante los seis meses previos a marzo de 2026, cifra que le valió a ChatGPT la designación de Motor de Búsqueda en Línea de Gran Tamaño. En el DevDay del 29 de septiembre, OpenAI mencionó 1200 millones de usuarios semanales. Si dividimos una cifra entre la otra, obtenemos el 13,3 %.
Consideremos esto como una estimación. Las cifras mensuales superan a las semanales, lo que reduce la cuota semanal real en la UE, mientras que el crecimiento de seis meses desde marzo la incrementa. Digamos que se trata aproximadamente de un usuario de ChatGPT de cada ocho.
Ahora bien, la multa. El artículo 99(4) calcula la sanción en función de la facturación mundial. Sobre los aproximadamente 13.100 millones de dólares de ingresos de 2025, según las declaraciones a inversores de OpenAI, el 3% equivale a unos 392 millones de dólares. Este límite no se reduce porque el umbral sea regional.
A continuación, se presentan tres cosas.
El cumplimiento se limita al desencadenante, no a la exposición. La multa es global, pero el desencadenante son los usuarios de la UE. OpenAI marcó exactamente el desencadenante. Eso es lo que exige la ley, nada más. Esto también significa que Bruselas no exportó su normativa esta vez. El modelo del RGPD, donde una regulación regional se convierte en la norma global por defecto, depende de que la división sea costosa. Para una empresa con el presupuesto de ingeniería de OpenAI, una geocerca en una configuración de muestreo resulta barata.
La encuesta dio un giro inesperado. En 2023, la marca de agua "un rival que no lo hizo" describía a todos los rivales. En 2026, Gemini aparece marcado y Claude aparece marcado en todas partes. Fuera de la UE, ChatGPT es la opción sin marcar entre los tres asistentes más importantes. Si tan solo una parte de esa preferencia declarada del 30 % se traduce en un comportamiento real, OpenAI habrá convertido la condición de la encuesta en una característica del producto que no necesita publicitar. La intención declarada en una encuesta de 2023 es una prueba débil del comportamiento de 2026, así que considérelo como una hipótesis que se pondrá a prueba en los próximos trimestres.
La decisión predeterminada es la correcta. Las funciones opcionales rara vez se modifican. La API es donde se construyen las granjas de contenido, las herramientas de SEO, las aplicaciones de redacción fantasma y las agencias, lo que la convierte en el hogar del mayor volumen de texto de la economía. Enviar la marca deja ese volumen sin marcar a menos que cada constructor decida que sus propias obligaciones requieren lo contrario. Hicimos una versión de este punto sobre Anthropic en agosto, y el diseño de OpenAI va un paso más allá. Anthropic marca la API y deja la divulgación a los clientes. OpenAI deja la marca en sí a los clientes. Es el mismo patrón que señalamos en los precios de los agentes de OpenAI: el producto principal se ve de una manera, y la configuración importante se encuentra en un nivel inferior.
Para los fundadores, la información práctica es breve. Si desarrollas sobre la API de OpenAI y prestas servicios a usuarios de la UE, la decisión sobre la marca de agua recae ahora sobre ti, al igual que la exposición al riesgo que conlleva el Artículo 50. Planifícalo antes de que un regulador o un cliente lo haga por ti.
El riesgo
Primero, el hombre de acero. La cautela de OpenAI está respaldada por evidencia. La detección cae al 17% después de que se intercambia una cuarta parte de las palabras, los pasajes cortos y matemáticos apenas se registran, y el 69% de sus propios usuarios le dijeron en 2023 que la detección produciría acusaciones falsas, que afectan más a los escritores no nativos de inglés. Como mostramos cuando mapeamos dónde las marcas de agua son delgadas, estos límites son estructurales, no un error que se solucionará con un parche. Lanzar en una región y aprender antes de expandirse globalmente es una forma defendible de implementar una herramienta tan sensible a errores, y OpenAI dice que revisará cada parte del enfoque.
En segundo lugar, la geocerca tiene límites. La publicación de OpenAI no especifica si "en la UE" se refiere al país de facturación, la región de la cuenta o el origen de la solicitud. Los residentes de la UE que viajan, las empresas de la UE con personal en el extranjero y los usuarios de VPN se encuentran en situaciones donde la marca se aplica o no, y en cada caso, un regulador puede plantear preguntas.
En tercer lugar, la estabilidad del mapa depende del número de jurisdicciones con reglas similares al Artículo 50. Cada nueva jurisdicción añade una región a la ruta, y un número suficiente de ellas restablecería la dinámica económica que impulsó a Anthropic a un escenario global único.
En cuarto lugar, la apuesta comercial podría tener el efecto contrario. Las escuelas, las editoriales y los compradores regulados podrían empezar a preguntar a los proveedores si sus productos están marcados, y «marcamos en todas partes» es un argumento fácil de usar en una presentación de ventas. Si los departamentos de compras empiezan a premiar la marca, el mapa exclusivo para la UE se convierte en un inconveniente.
Por último, la estimación de cobertura. Esta combina una métrica mensual de la UE con una global semanal, medidas con seis meses de diferencia. El argumento no depende de la cifra exacta. Cualquier valor entre el 10 % y el 20 % transmite el mismo mensaje.
Preguntas rápidas
¿ChatGPT añadirá una marca de agua a mi texto si estoy fuera de la UE? No por defecto. OpenAI afirma que el lanzamiento de ChatGPT y Codex solo abarcará la UE en su fase inicial.
¿Alguien puede comprobar si un texto proviene de ChatGPT? Todavía no. El acceso al detector está restringido a investigadores y organizaciones expertas autorizadas, y OpenAI afirma que no hará pública la herramienta en su lanzamiento.
¿La marca de agua me identifica? No. OpenAI afirma que la marca no vincula el texto con una persona, cuenta, mensaje o conversación.
¿Puede la edición eliminarlo? En parte. En las propias pruebas de OpenAI, cambiar el 10% de las palabras por sinónimos redujo la detección de aproximadamente el 92% al 66%, y cambiar el 25% la redujo al 17%.
¿La salida de la API lleva la marca? Solo si el cliente lo autoriza, en modelos seleccionados, en cualquier parte del mundo.
La perspectiva del analista de modelos de negocio
OpenAI cumplió con lo que la ley exige y nada más, lo cual es una maniobra corporativa de lo más común. Lo que merece la pena analizar es su naturaleza. La sanción es global, la obligación es regional, y la empresa trazó su marca alrededor de la obligación con una precisión que Anthropic afirmó no poder igualar.
La lección más importante para cualquiera que desarrolle sobre estos modelos es que la procedencia se ha convertido en una variable competitiva. Tres laboratorios, una ley, tres mapas diferentes. Google marca por defecto, Anthropic marca en todas partes y OpenAI marca donde debe. Cada mapa es una apuesta sobre lo que los usuarios y compradores valorarán, y no todas las apuestas pueden ser correctas. El resultado se verá en dos momentos: el 2 de febrero de 2027, cuando la detección tenga que funcionar entre proveedores, y el primer gran comprador que incluya "solo resultados marcados" en un contrato. Para conocer la trayectoria a largo plazo de cómo OpenAI genera ingresos, consulte nuestro análisis del modelo de negocio de OpenAI.
Hasta entonces, la encuesta de 2023 que mantuvo la marca de agua de OpenAI en suspenso sigue en marcha. Simplemente cuenta con un nuevo participante.